
Desempeño de la MCU Cortex-M3 Deep-Dive: Especificaciones y puntos de referencia
Análisis Profundo del Rendimiento del MCU Cortex-M3:
Especificaciones y Benchmarks
El propósito de este análisis profundo es proporcionar a los ingenieros un mapa compacto, basado en hojas de datos y benchmarks, sobre qué esperar de las implementaciones del MCU Cortex-M3. Basándose en conjuntos de benchmarks públicos y prácticas de laboratorio repetibles, el artículo explica qué especificaciones importan, cómo deben interpretarse los benchmarks sintéticos y del mundo real, y cómo ejecutar pruebas reproducibles para que los equipos puedan elegir y ajustar objetivos con confianza.
Análisis Avanzado
Por qué el MCU Cortex-M3 Sigue Siendo Importante
Aspectos Destacados de la Arquitectura
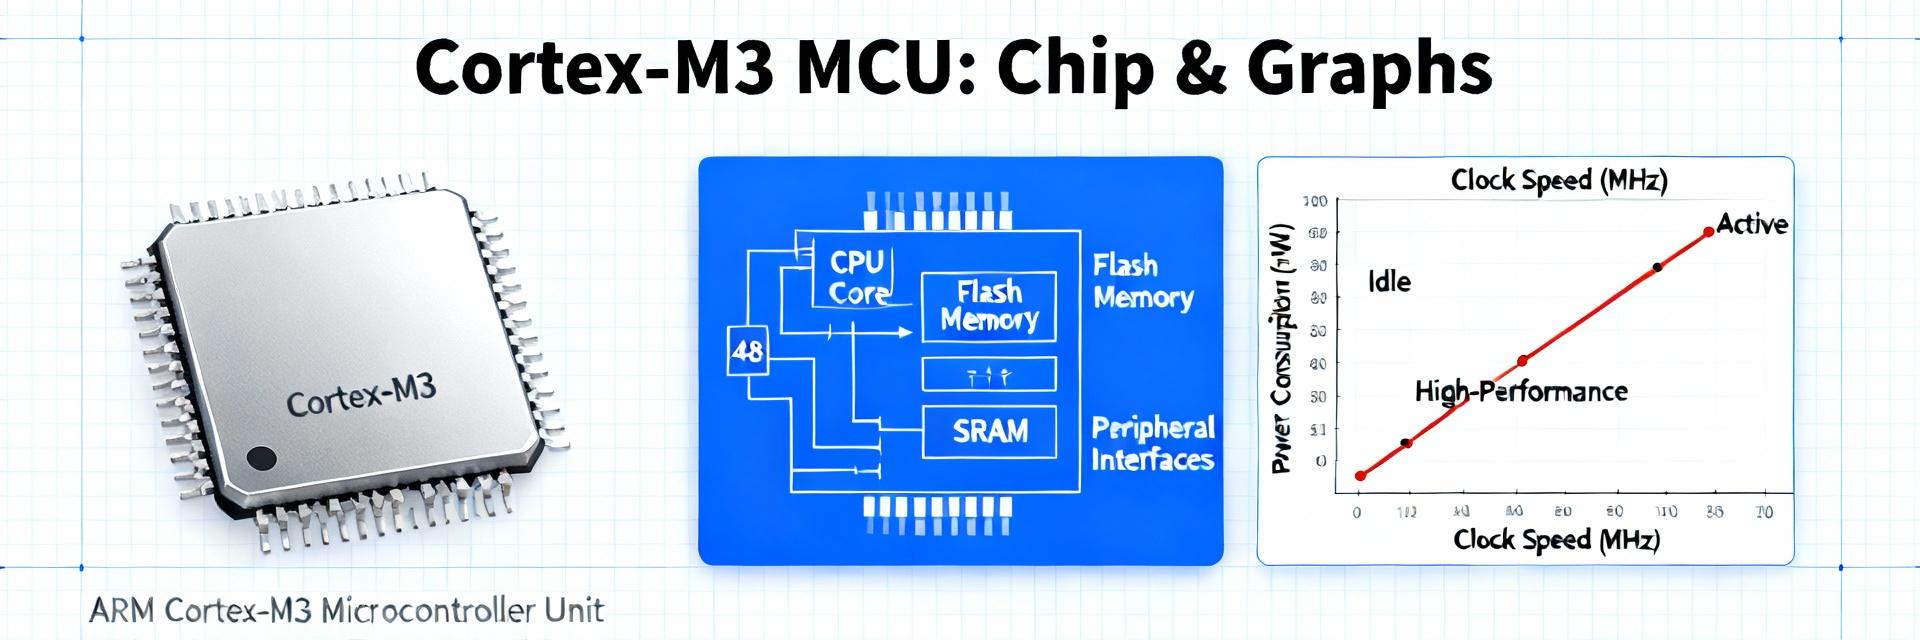
Punto: El núcleo Cortex-M3 combina una canalización de 3 etapas, un modelo de interrupción NVIC determinista, MPU opcional y un sistema de memoria que a menudo define el rendimiento real.
Evidencia: Las hojas de datos y las referencias de arquitectura muestran los relojes típicos de M3 y las interfaces de bus que impulsan los estados de espera y la latencia de interrupción.
Explicación: La canalización corta favorece una respuesta ISR predecible; la priorización del NVIC mantiene baja la latencia de cola; la interfaz flash y el tamaño de la SRAM determinan las paradas de búsqueda de instrucciones e IPC efectivo bajo carga.
Entorno de Aplicación Típico
Punto: La clase M3 se dirige al control embebido y en tiempo real de gama media.
Evidencia: El uso en el campo incluye accionamientos de motores, puertas de enlace industriales y productos de consumo de nivel medio donde el determinismo y la densidad de código importan.
Explicación: Los equipos eligen M3 sobre M0/M0+ de menor potencia para conjuntos de periféricos más ricos y sobre clases superiores para un menor consumo de energía y cadenas de herramientas más simples.
Especificaciones Clave para Comparar entre MCUs Cortex-M3
Relojes de Núcleo, Eficiencia de Ejecución y Jerarquía de Memoria
Punto: Los MHz del núcleo, el tamaño de la flash, la SRAM y el comportamiento del estado de espera de la flash son campos de especificación primarios que predicen el rendimiento.
Rango de Rendimiento Típico (MHz del Núcleo)
- [LISTA DE VERIFICACIÓN] MHz máximos; Tamaño e interfaz de Flash (estados de espera); Tamaño de SRAM y bancos; Presencia de ROM/gestor de arranque; Tabla de estado de espera de Flash vs voltaje/reloj.
Periféricos, Buses y Características de Energía
Punto: La arquitectura periférica y la topología del bus cambian el rendimiento y la latencia medidos. Evidencia: Las piezas con DMA, puentes AHB/APB más anchos y múltiples maestros periféricos descargan la CPU y reducen las transferencias impulsadas por interrupciones.
Accionable: Registre la presencia de DMA, anchos de bus, número de canales ADC y tiempos de entrada/salida de bajo consumo para una comparación realista de benchmarks.
Benchmarks y Análisis de Rendimiento
Benchmarks Sintéticos
CoreMark y Dhrystone producen métricas repetibles similares a IPC. Use versiones idénticas de la cadena de herramientas y banderas de optimización (-O2).
-O2 -fno-common -ffunction-sections
Pruebas del Mundo Real
Las distribuciones de latencia ISR medidas y el rendimiento sostenido de DMA muestran dónde el arbitraje de bus crea cuellos de botella.
- Distribución de latencia (Mín/Máx/Jitter)
- Rendimiento (Bytes/seg)
- Consumo de energía durante ráfagas
Cómo Ejecutar Pruebas de Benchmark de Cortex-M3 Repetibles
Entorno de Prueba y Repetibilidad
La repetibilidad depende de relojes estables, energía aislada y condiciones térmicas controladas. Bloquee las fuentes de reloj y use un analizador lógico para la temporización.
Recomendaciones Prácticas para Diseñadores
| Prioridad | Qué Comprobar | Ayuda de Decisión |
|---|---|---|
| Latencia | Comportamiento del NVIC, estados de espera de flash, entrada/salida de ISR | Preferir estados de espera bajos, ubicación en RAM |
| Rendimiento | MHz, canales DMA, ancho de bus | Elegir piezas con mayor MHz y habilitadas para DMA |
| Memoria | Tamaño/bancos de SRAM, tamaño de flash | Hacer coincidir la huella de código+datos con margen |
Consejos de Optimización
Pequeños pasos de ajuste a menudo producen ganancias significativas. Mueva las rutinas críticas a la RAM, alinee los datos y habilite el DMA para transferencias masivas.
Conclusión
Las plataformas de MCU Cortex-M3 ofrecen una mezcla predecible de manejo de interrupciones determinista, computación de gama media y conjuntos de periféricos ricos, pero el rendimiento en el mundo real depende tanto de las especificaciones como de cómo se evalúa y ajusta el dispositivo.
Primero los MHz, los estados de espera de Flash y la SRAM para el rendimiento.
CoreMark por MHz para métricas de computación base.
Banderas de compilación y captura de metadatos para ejecuciones repetidas.
Preguntas Frecuentes
¿Cómo medir la latencia de interrupción del MCU Cortex-M3? +
¿Qué benchmarks reflejan mejor el rendimiento de computación del MCU Cortex-M3? +
¿Cómo realizar el ajuste de potencia frente a rendimiento del MCU Cortex-M3? +