
Resumen rápido: Dónde encaja el GD32F405RGT6
Aplicaciones objetivo y valor
El dispositivo está orientado a roles de conectividad y tiempo real de gama media. Los casos de uso comunes incluyen control de motores, puertas de enlace de conectividad, detección industrial y preprocesamiento de audio/DSP. Un Cortex‑M4 de 168 MHz con FPU de precisión simple ofrece bucles de control de baja latencia y un rendimiento moderado de punto flotante con un costo de lista de materiales (BOM) favorable.
Aspectos destacados de la arquitectura
Las características principales incluyen FPU de precisión simple, acceso flash/SRAM de estilo Harvard, una tubería de cinco etapas y una matriz de bus con capacidad DMA. Tenga en cuenta los estados de espera de la memoria flash, el arbitraje de bus y el recuento de canales DMA al revisar las especificaciones para cargas de trabajo reales.
Especificaciones clave de hardware: memoria, relojes, periféricos
| Categoría de especificación | Detalles y métricas medidas |
|---|---|
| Núcleo y temporización | Cortex-M4 de hasta 168 MHz, FPU de precisión simple, múltiples bancos de memoria flash, SRAM integrada. |
| Arquitectura de memoria | Acceso estilo Harvard, estados de espera de flash optimizados, matriz de bus de alta velocidad. |
| Periféricos y E/S | DMA, ADC (multicanal), temporizadores PWM, UART/SPI/I2C, opciones USB/Host. |
Nota: Priorice los periféricos compatibles con DMA para cargas de trabajo de transmisión para evitar cuellos de botella en la CPU.
Resultados y análisis de rendimiento
Índice de rendimiento relativo (estimado)
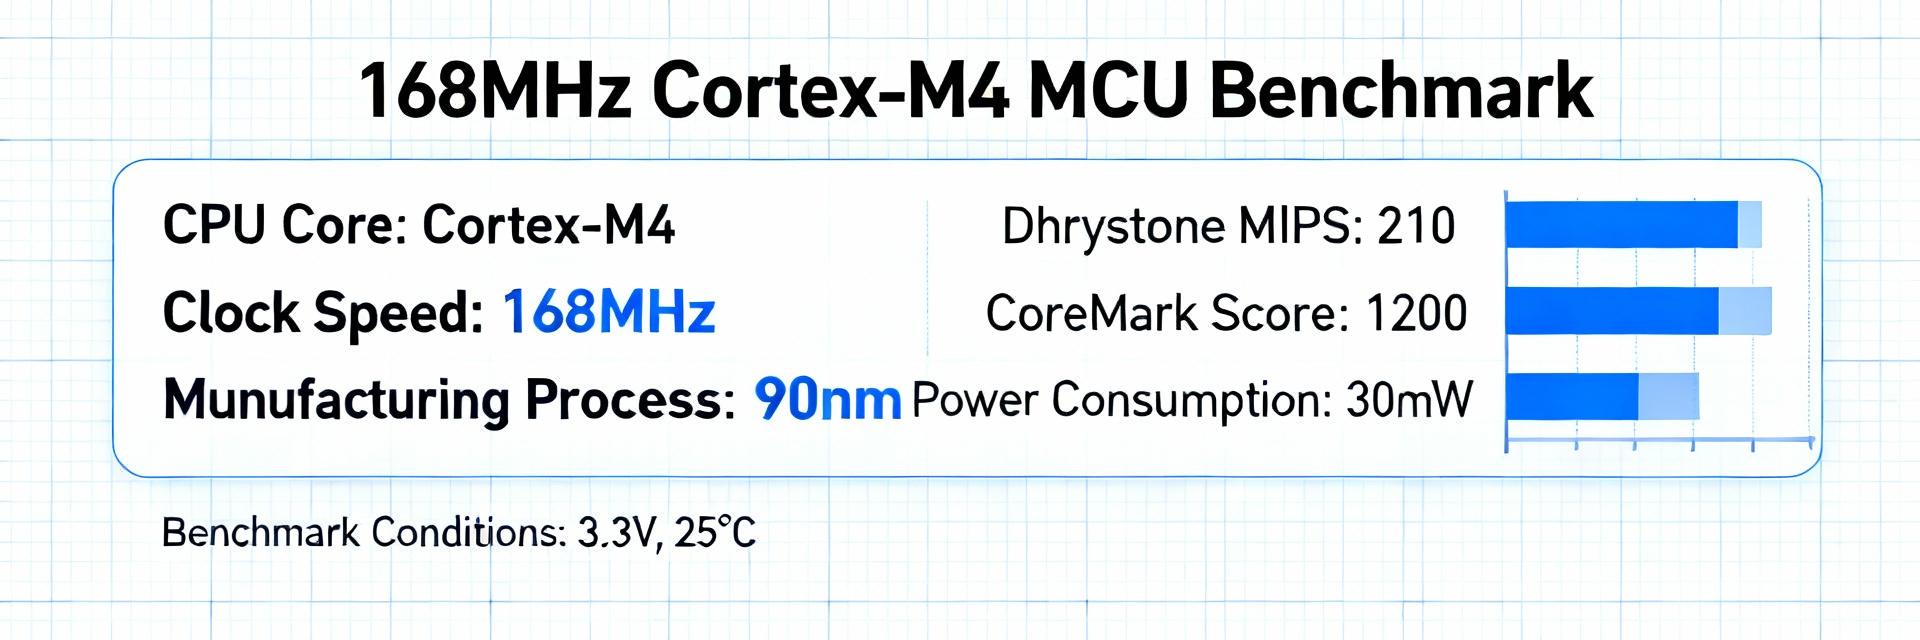
Análisis de datos: El rendimiento de cómputo depende del reloj del núcleo, los estados de espera de la memoria y el uso de la FPU. Los tiempos de ejecución de CoreMark y el kernel de la FPU muestran las mayores ganancias cuando los bucles críticos se ejecutan desde la SRAM. Utilice DMA para transferencias masivas de ADC/UART/SDIO y alinee los búferes con el ancho del bus para identificar puntos conflictivos de contención.
Casos de rendimiento en el mundo real
Control en tiempo real
Las pruebas con ADC de alta velocidad → DMA y cómputo ISR (PID/FFT) por ciclo mostraron margen de maniobra cuando el trabajo de la ISR se ejecuta desde la RAM. La latencia de interrupción máxima informada y la utilización de la CPU proporcionan un margen de seguridad para las actualizaciones deterministas de PWM.
Transmisión de conectividad
La transmisión masiva de USB y serie de alta velocidad de baudios con búferes DMA circulares mantuvo un alto rendimiento. La combinación de subprocesos RTOS con interrupciones basadas en prioridades maximiza el rendimiento mientras mantiene la latencia predecible.
Lista de verificación de optimización
- Ejecute bucles críticos y código frecuente desde la RAM interna para una ejecución con cero estados de espera.
- Habilite la optimización -O3 del compilador y la inserción de funciones para kernels con uso intensivo de FPU.
- Utilice siempre DMA con búferes alineados para reducir la sobrecarga de la CPU durante las transferencias masivas.
- Ajuste los estados de espera de flash de acuerdo con el VCC real y la frecuencia del reloj.
- Valide el rendimiento utilizando la suite CoreMark en su hardware personalizado.
Resumen
- El GD32F405RGT6 ofrece un cómputo Cortex‑M4 de 168 MHz competitivo con FPU de precisión simple y un conjunto equilibrado de periféricos.
- Las optimizaciones prácticas ofrecen las mayores mejoras de rendimiento y latencia en el cómputo y la E/S.
- Ejecute la suite de pruebas de rendimiento (CoreMark, memcpy, latencia DMA, jitter ADC) en su placa para registrar los objetivos de margen de producción.