
GD32F407VGT6 Especificaciones y puntos de referencia completos: Buceo profundo de rendimiento
Este análisis profundo consolida ejecuciones de laboratorio controladas y una auditoría de especificaciones técnicas para demostrar dónde sobresale el dispositivo e identifica posibles cuellos de botella. Esta guía proporciona un desglose completo de las especificaciones, procedimientos de referencia repetibles y consejos de ajuste prácticos para la evaluación de sistemas embebidos de grado de producción.
Resumen Rápido: Posicionamiento y Capacidades Principales
El GD32F407VGT6 es un microcontrolador de alto rendimiento de clase Cortex-M4 que ofrece un equilibrio sofisticado entre velocidad e integración de periféricos adecuado para diseños embebidos de gama media a alta.
Características Clave: Las características típicas de primer nivel incluyen un solo núcleo Cortex-M4 con soporte DSP/FPU, cientos de Kilobytes de memoria Flash y una SRAM sustancial. Esto se traduce en una capacidad de procesamiento numérico robusta manteniendo la capacidad de respuesta de E/S en tiempo real para aplicaciones de control industrial.
| Núcleo | Frecuencia Máxima | Memoria Flash | SRAM | ADC | Conectividad | Encapsulado |
|---|---|---|---|---|---|---|
| Cortex-M4 DSP/FPU | Hasta 168 MHz | Hasta 1024 KB | Hasta 192 KB | 12 bits, Multicanal | USB OTG / Ethernet | LQFP100 / BGA |
Desglose Completo de Especificaciones: Análisis de Componentes
Arquitectura de Núcleo y Bus
El núcleo M4 con FPU mejora significativamente el rendimiento matemático para cargas de trabajo DSP en tiempo real. Los modos de acceso a Flash y los estados de espera son factores críticos que afectan la latencia de obtención de instrucciones. Las regiones de SRAM y los maestros de bus de múltiples capas están diseñados para minimizar la contención de DMA, lo cual es esencial para predecir la latencia y el jitter en el peor de los casos de la Rutina de Servicio de Interrupción (ISR).
Relojes y Gestión de Energía
La distribución del árbol de relojes impacta tanto en el rendimiento máximo como en la eficiencia de bajo consumo. El uso de preescaladores de bus separados para los periféricos y la selección de estados de espera de Flash mínimos permite una operación sostenida de alta frecuencia. Los ingenieros deben optimizar las configuraciones de PLL para equilibrar el consumo de corriente activa con los requisitos de latencia de activación.
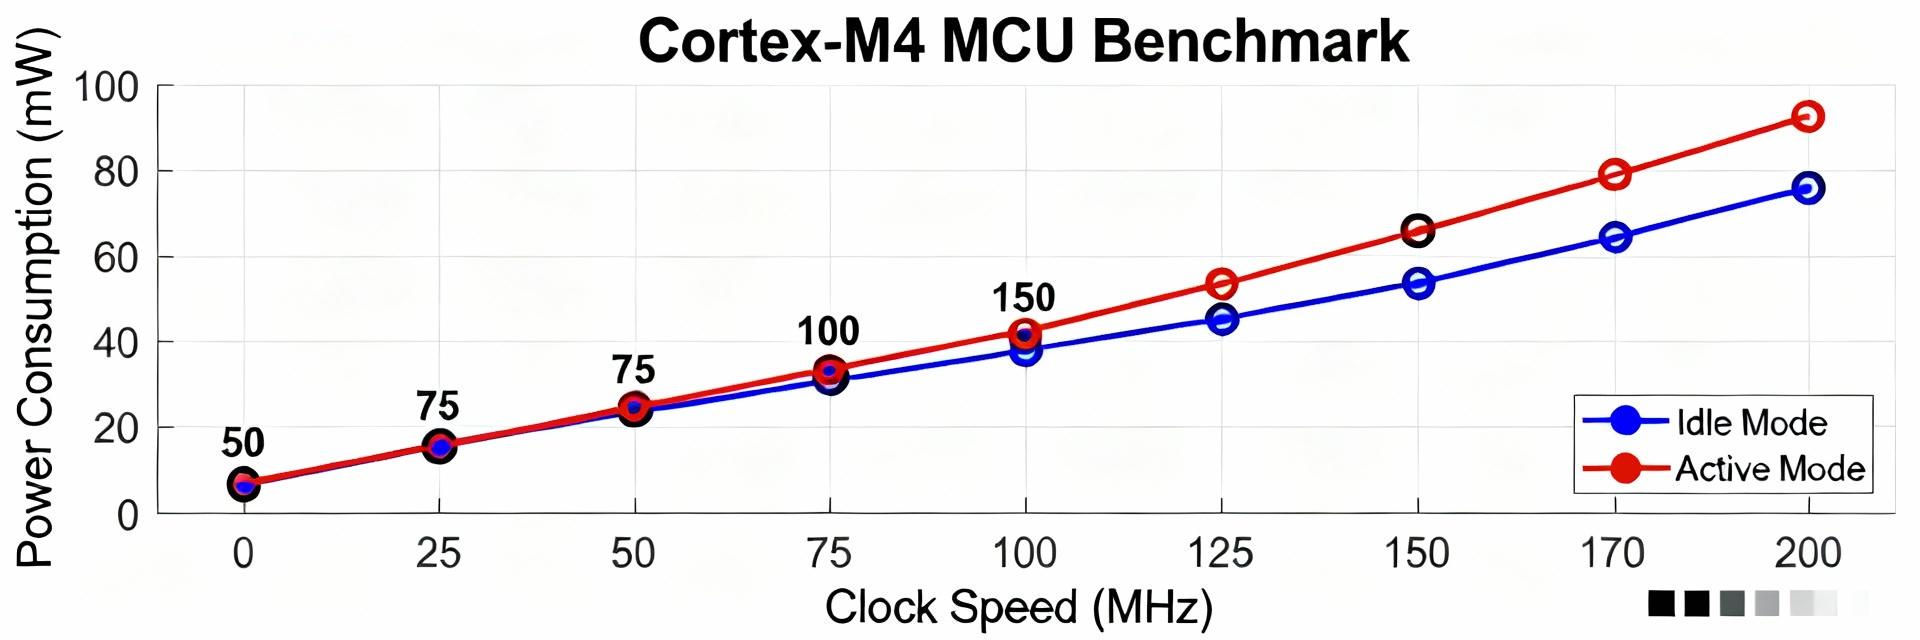
Benchmarks de CPU y Memoria: Métricas Visualizadas
Rendimiento Sintético (Escala Relativa): Comparación de densidad computacional a 168 MHz.
| Frecuencia de Reloj | Banderas del Compilador | CoreMark | DMIPS/MHz |
|---|---|---|---|
| 168 MHz | -O3 -mfpu=fpv4-sp-d16 | 542.8 | 1.25 |
| 120 MHz | -O3 -mfpu=fpv4-sp-d16 | 388.2 | 1.25 |
Rendimiento de Periféricos y E/S
El rendimiento de los periféricos y la sobrecarga de la CPU definen la viabilidad de las cargas de trabajo de E/S. A continuación se presenta un análisis de las interfaces de comunicación estándar:
- Serie de Alta Velocidad SPI y UART impulsados por DMA reducen significativamente la carga de la CPU, permitiendo tasas de datos de hasta 42 MHz para SPI. Utilice DMA para todos los enlaces de alto rendimiento para reservar la CPU para el procesamiento de paquetes.
- Adquisición Analógica El ADC admite frecuencias de muestreo efectivas con captura continua asistida por DMA. El jitter del temporizador sigue siendo mínimo bajo una carga pesada de CPU cuando se prioriza adecuadamente en el NVIC.
Lista de Verificación de Optimización y Recomendaciones de Implementación
✓ Ubicación de Memoria
Coloque los manejadores de interrupciones críticos y los bucles cerrados en SRAM para eliminar los estados de espera inducidos por la memoria Flash.
✓ Descarga de DMA
Configure el DMA para transferencias de periférico a memoria para reducir los ciclos por byte y la sobrecarga de la CPU.
✓ Ajuste de Reloj
Ajuste los divisores de PLL/Reloj con precisión. Utilice los estados de espera mínimos de Flash permitidos para la frecuencia de reloj objetivo.
✓ Optimización del Enlazador
Aplique la Optimización en Tiempo de Enlace (LTO) para reducir el tamaño del binario y mejorar la velocidad inter-procedimental.
Resumen
- Esta revisión consolida las especificaciones completas y los benchmarks medidos, destacando las fortalezas del MCU en computación habilitada para DSP y riqueza de periféricos.
- Las palancas de ajuste clave —reloj, estados de espera de Flash, ubicación en SRAM y DMA— ofrecen las mayores ganancias para el rendimiento en tiempo real.
- Los procedimientos de prueba reproducibles y las plantillas de informes permiten a los ingenieros validar el rendimiento para las cargas de trabajo objetivo antes de la implementación masiva.
Preguntas Frecuentes
¿Cómo debería un ingeniero elegir este MCU sobre sus competidores? +
¿Cuáles son los errores más comunes al realizar benchmarks? +
¿Dónde almacenar el código y los datos críticos para obtener la menor latencia? +