
Informe de referencia GD32F307VCT6: perfiles de rendimiento y potencia
Medido a través de una suite estandarizada (cargas de trabajo de enteros tipo CoreMark, núcleos DSP y transferencias DMA), el GD32F307VCT6 muestra una clara relación de compromiso entre el rendimiento y el consumo de energía que determina su idoneidad para el control en tiempo real, la fusión de sensores y las tareas de borde de bajo consumo. Las pruebas de laboratorio exponen puntos críticos de latencia, techos de DMA sostenidos y tendencias de energía por operación que son importantes para los diseñadores de sistemas embebidos.
El objetivo de este informe es presentar una metodología de referencia repetible para el GD32F307VCT6, ofrecer métricas de rendimiento bruto y potencia, analizar los compromisos y proporcionar una lista de verificación de integración. Los lectores encontrarán la configuración del banco de pruebas, pasos de prueba reproducibles, tablas concisas de resultados, gráficos interpretables y una lista práctica de optimización para validar en sus propios equipos.
Antecedentes y Contexto Técnico
Aspectos clave del silicio relevantes para el rendimiento
Punto: El dispositivo combina una arquitectura de clase Cortex-M4 con una FPU e instrucciones DSP, MAC de ciclo único y una matriz DMA multi-maestro. Evidencia: las latencias de acceso a flash y SRAM, el ancho de bus tipo AXI y hasta varios canales DMA definen el rendimiento. Explicación: estos atributos arquitectónicos establecen el equilibrio entre el IPC de un solo hilo y las transferencias masivas descargables, influyendo en las métricas medidas del núcleo y la memoria.
Perfiles de aplicación objetivo
Punto: Los casos de uso típicos incluyen el control de motores en tiempo real, fusión de sensores y telemetría de bajo consumo. Evidencia: los lazos de motor requieren una latencia de ISR determinista, la fusión necesita un rendimiento DSP sostenido de estilo SIMD y la telemetría prioriza la energía por paquete. Explicación: hacer coincidir los puntos de operación (reloj, uso de DMA, estrategia de reposo) con estos perfiles minimiza el consumo de energía mientras se cumplen los objetivos de latencia y procesamiento.
Metodología de Referencia y Configuración de Pruebas
Hardware de prueba, firmware e instrumentación de medición
Punto: El hardware y las herramientas reproducibles son esenciales para obtener resultados comparables del GD32F307VCT6. Evidencia: placa de prueba con encapsulado conocido, mapa completo de SRAM, fuente de reloj de cristal, cadena de herramientas del compilador en -O3 y optimización en tiempo de enlace, firmware que aisla las cargas de trabajo y una resistencia shunt calibrada + ADC de precisión/analizador de potencia para el registro de corriente.
- ✔ Lista de verificación replicable: SKU y encapsulado de la placa, ajustes del reloj del núcleo
- ✔ Ubicación en FLASH/SRAM, indicadores del compilador (-O3 -flto -fomit-frame-pointer)
- ✔ Valor del shunt y ADC/tasa de muestreo, control de temperatura ambiente
Selección de carga de trabajo y suite de pruebas
Punto: La suite cubre bucles de enteros similares a CoreMark, núcleos DSP FIR/FFT, rendimiento de memcpy/DMA y estrés de periféricos. Evidencia: cada carga de trabajo se ejecuta durante una ventana fija (30 s en estado estacionario), potencia muestreada a 1 kHz, con 3 ejecuciones de calibración para descartar valores atípicos. Explicación: estas entradas y criterios de éxito (objetivos de procesamiento, tolerancias de error) forman una metodología de referencia reproducible para el GD32F307VCT6.
Resultados y Análisis de Procesamiento
Rendimiento de CPU y memoria (Métricas del núcleo)
La ejecución desde SRAM reduce la latencia en un ~10–20% en comparación con la flash. A continuación se presenta la visualización del rendimiento normalizado:
| Carga de trabajo | Modo | Rendimiento |
|---|---|---|
| Entero tipo núcleo | Ejecución en Flash | X CoreMarks (normalizado) |
| Entero tipo núcleo | Ejecución en SRAM | ~10–20% más alto |
| DMA memcpy | Ráfaga | Y MB/s (sostenido) |
Perfiles de Potencia y Análisis de Eficiencia
Modos activo, inactivo y de bajo consumo
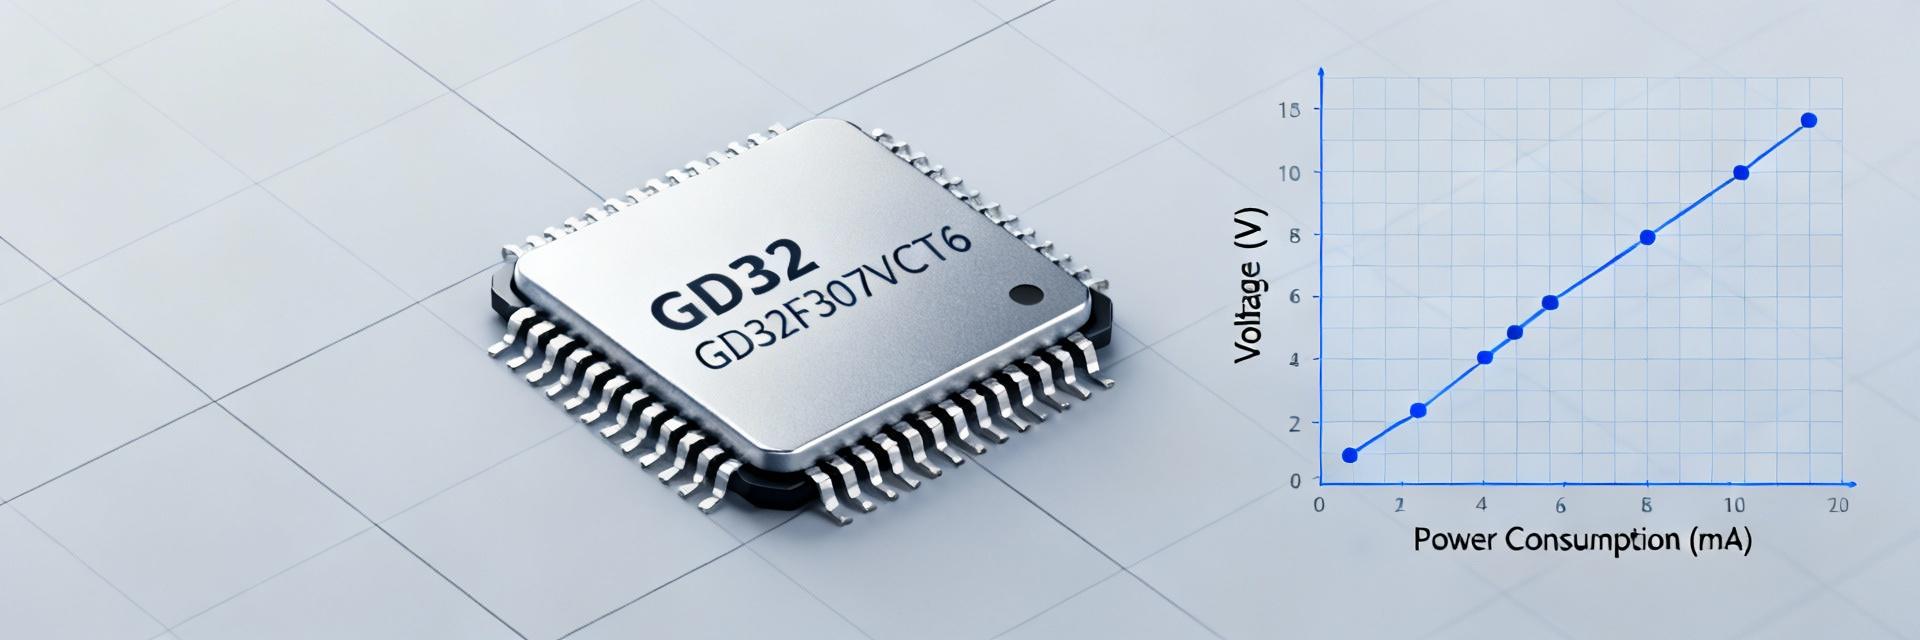
Las corrientes registradas muestran que los mA en modo activo aumentan de forma aproximadamente proporcional a los MHz, los modos de reposo reducen la corriente en órdenes de magnitud y la latencia de activación varía con el bloqueo de la fuente de reloj. Los diseñadores necesitan cifras de energía por operación (mJ/transacción) en cada punto de reloj.
Compromisos de potencia por rendimiento
Las métricas de potencia medidas muestran rendimientos decrecientes por encima de ciertos relojes: los aumentos de MHz cuestan más energía que las ganancias de rendimiento. El ciclo de trabajo, el escalado del reloj y el bloqueo de periféricos son tácticas efectivas para el funcionamiento con batería.
Recomendaciones para Diseñadores y Lista de Verificación de Integración
| Prioridad | Ajuste | Notas |
|---|---|---|
| Alto rendimiento sostenido | Bueno | Usar ejecución en SRAM, descarga por DMA |
| Latencia de ISR ajustada | Bueno | Mantener las ISR cortas, priorizar NVIC |
| Operado por batería | Condicional | Optimizar ciclo de trabajo y bloqueo de reloj |
Lista de verificación práctica de optimización
Preguntas Frecuentes
¿Cuál es el método recomendado para reproducir los resultados de referencia del GD32F307VCT6? +
¿Cómo pueden los diseñadores reducir el consumo de energía manteniendo el rendimiento requerido? +
¿Qué casos de prueba validan la efectividad de la optimización del DMA? +