
El alcance de la prueba cubre el rendimiento, la latencia y la potencia dinámica/estática a través de microbenchmarks y núcleos de aplicaciones, con notas de medición reproducibles y consejos de ajuste prácticos.
01 Antecedentes: Arquitectura y Especificaciones Clave
Arquitectura de Núcleo y Reloj
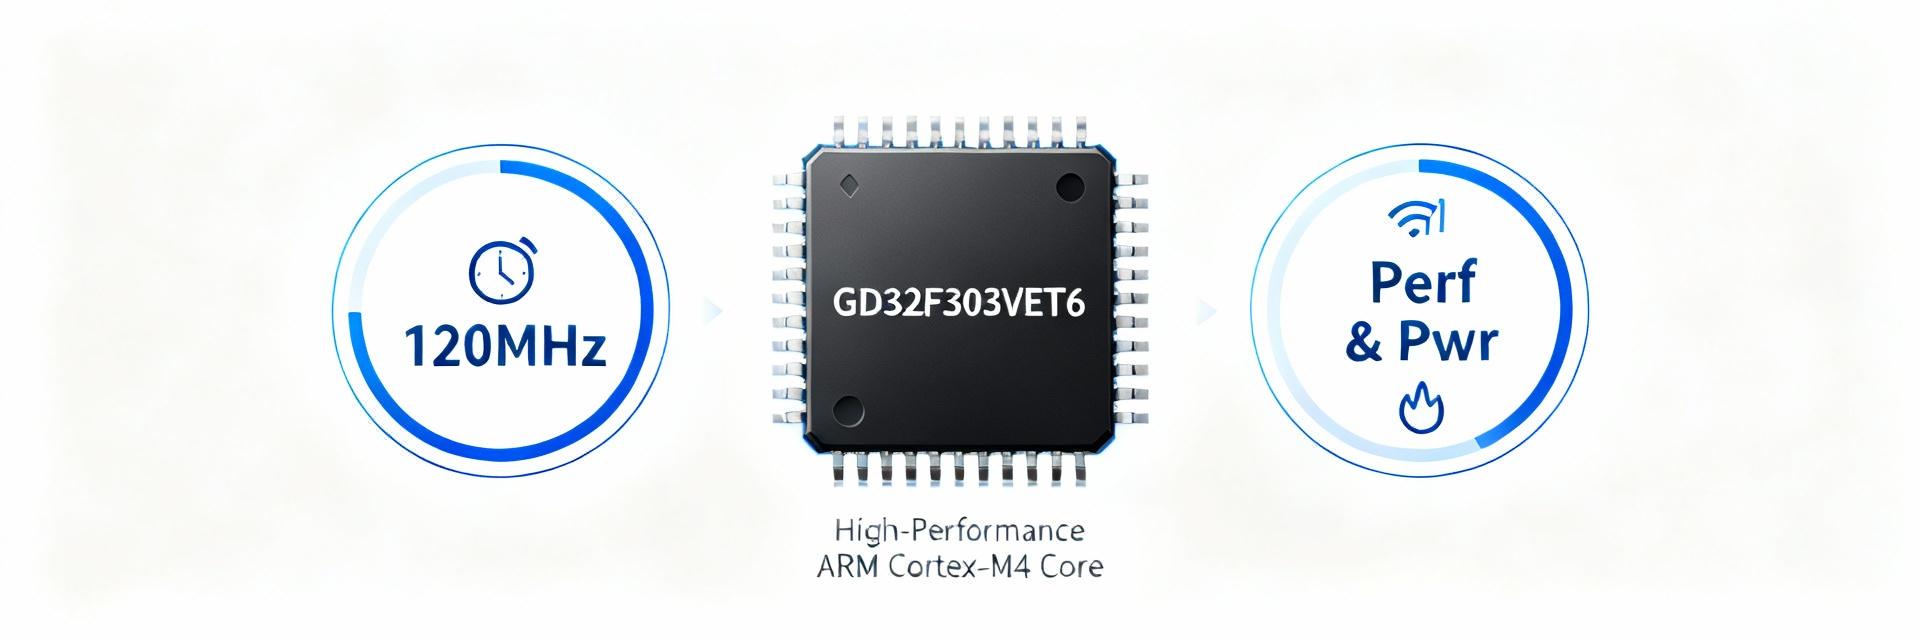
Punto: El MCU utiliza un núcleo Cortex-M4 con FPU de precisión simple y un reloj de sistema de hasta 120 MHz.
Evidencia: 512 KB de flash y ~80 KB de SRAM son las métricas principales de la hoja de datos.
Explicación: Los 120 MHz permiten una respuesta ISR de menor latencia; la FPU acelera los cálculos de FFT y PID, mientras que el tamaño de la SRAM afecta el rendimiento de memcpy.
Periféricos Integrados
Punto: La descarga de periféricos es una palanca de rendimiento principal.
Evidencia: Controladores DMA integrados, múltiples instancias SPI/I2S y ADC multicanal.
Explicación: El uso de DMA para lecturas de ADC mantiene la CPU disponible para tareas de control; los temporizadores reducen la fluctuación (jitter) de ISR para el control de motores.
02 Resultados de Benchmarks Reales
Microbenchmarks: CoreMark y Dhrystone
Las pruebas sintéticas de escala de núcleo cuantifican la capacidad bruta de la CPU y la sensibilidad del compilador.
Pruebas a Nivel de Aplicación: FFT y Latencia
Evidencia: Una FFT de precisión simple de 256 puntos se ejecutó en ~0,9 ms a 120 MHz con FPU. Memcpy alcanza picos cercanos a 1600 MB/s de ancho de banda efectivo del bus.
Explicación: La FFT se benefició enormemente de la FPU y la ubicación en SRAM; el arbitraje del bus sigue siendo el próximo cuello de botella para casos de uso de mayor rendimiento.
03 Análisis de Potencia y Eficiencia
Metodología de medición
La corriente se midió en el VIN de la placa utilizando un medidor de potencia de banco de precisión (suministro de 3,3 V). Informar tanto las corrientes activas constantes como los transitorios de despertar a reposo permite un presupuesto energético preciso.
Potencia por MHz
- ✦ 120 MHz Activo: ~36 mA
- ✦ 72 MHz Activo: ~22 mA
- ✦ Sueño profundo (Deep-Sleep): µA de un solo dígito
04 Metodología y Reproducibilidad
La repetibilidad requiere descripciones precisas de la placa. Utilice una placa de prueba con una única ruta de suministro y DAQ de 24 bits. Entorno de software: GCC arm-none-eabi con -O3 y -mfpu=fpv4-sp-d16. Vincule el código crítico a la SRAM para los bucles principales (hot loops).
Caso de Control de Motores
Un bucle de control de 20 kHz (FOC) consumió ~45% de CPU a 120 MHz con un jitter de ISR <1,5 µs. Aumentar la tasa de muestreo requiere mover las transformaciones a bloques DSP.
Nodo IoT de bajo consumo
El despertar en frío a activo tomó ~2,4 ms (~300–400 µJ). Para telemetría infrecuente, un sueño más prolongado con transmisiones por lotes domina la duración de la batería.
05 Recomendaciones Prácticas
Lista de Verificación de Optimización
- Habilite la FPU de hardware para núcleos de cálculo intensivo.
- Mueva el código principal y los vectores de interrupción a la SRAM.
- Utilice la optimización del compilador -O3 para el rendimiento.
- Aproveche los motores DMA para todas las transferencias de datos masivas.
Tácticas de Ahorro de Energía
- Implemente el escalado dinámico de frecuencia (DFS).
- Cierre los relojes (clock gating) de todos los periféricos no utilizados.
- Seleccione los modos de sueño basados en la latencia de despertar.
- Agrupe los datos de los sensores para minimizar los ciclos de despertar/sueño.
Resumen Ejecutivo
La plataforma medida muestra un sólido rendimiento a altas velocidades de reloj, ofreciendo al mismo tiempo una potencia competitiva cuando se utiliza la descarga de periféricos y el escalado de frecuencia.