
Informe de rendimiento de GD32F470IKH6: puntos de referencia de MCU del mundo real
Informe de rendimiento del GD32F470IKH6: Benchmarks de MCU en el mundo real
Este informe compila resultados de pruebas de rendimiento del mundo real en pruebas de CPU, DSP, memoria, E/S y energía para cuantificar cómo se desempeña el GD32F470IKH6 bajo cargas de trabajo integradas representativas.
La intención es proporcionar benchmarks de MCU claros, metodología y orientación de ajuste accionable para desarrolladores integrados que evalúan las compensaciones de rendimiento, latencia y energía.
01 Antecedentes del dispositivo: qué esperar del GD32F470IKH6
Especificaciones clave que definen el rendimiento
Punto: Espere un núcleo Cortex-M de clase 240 MHz con FPU de precisión simple y extensiones DSP, bus multicapa y estructura DMA.
Evidencia: La alta velocidad de reloj, la FPU y los bloques DSP aceleran directamente las operaciones de punto flotante y de señal.
Explicación: Estas características impulsan el cómputo bruto para bucles de control y cadenas de señales, mientras que el DMA y el número de periféricos determinan la E/S sostenida y el rendimiento del sistema.
Definiendo el "rendimiento" para este MCU
Punto: Defina un conjunto compacto de métricas que medirá.
Evidencia: CoreMark/DMIPS para cómputo de enteros, FLOPS de precisión simple y ciclos CMSIS-DSP para trabajo de señales.
Explicación: Estas métricas separan las tareas limitadas por cómputo (control, DSP) de las tareas limitadas por E/S (transmisión de sensores) y enmarcan el comportamiento esperado del sistema.
Metodología de benchmarking: banco de pruebas y reproducibilidad
Configuración de hardware y cadena de herramientas
Punto: Utilice un dispositivo de prueba determinista y documente cada ajuste.
Evidencia: Placa de prueba con fuente de reloj externa, rieles de alimentación controlados y cadena de herramientas arm-none-eabi con indicadores de optimización explícitos.
Explicación: Los resultados reproducibles requieren un reloj fijo, relojes dinámicos desactivados e indicadores de optimización especificados (O2/O3/LTO) para mediciones repetibles.
Suites de benchmarking y selección de carga de trabajo
Punto: Elija suites que se mapeen a cargas de trabajo reales.
Evidencia: CoreMark/Dhrystone para CPU, FFT/FIR de CMSIS-DSP para la ruta de señal y pruebas de transferencia DMA para E/S.
Explicación: Esta matriz mapea microbenchmarks a categorías de aplicaciones para que los resultados pronostiquen la capacidad del sistema.
02 Resultados de CPU y DSP: benchmarks de cómputo bruto y procesamiento de señales
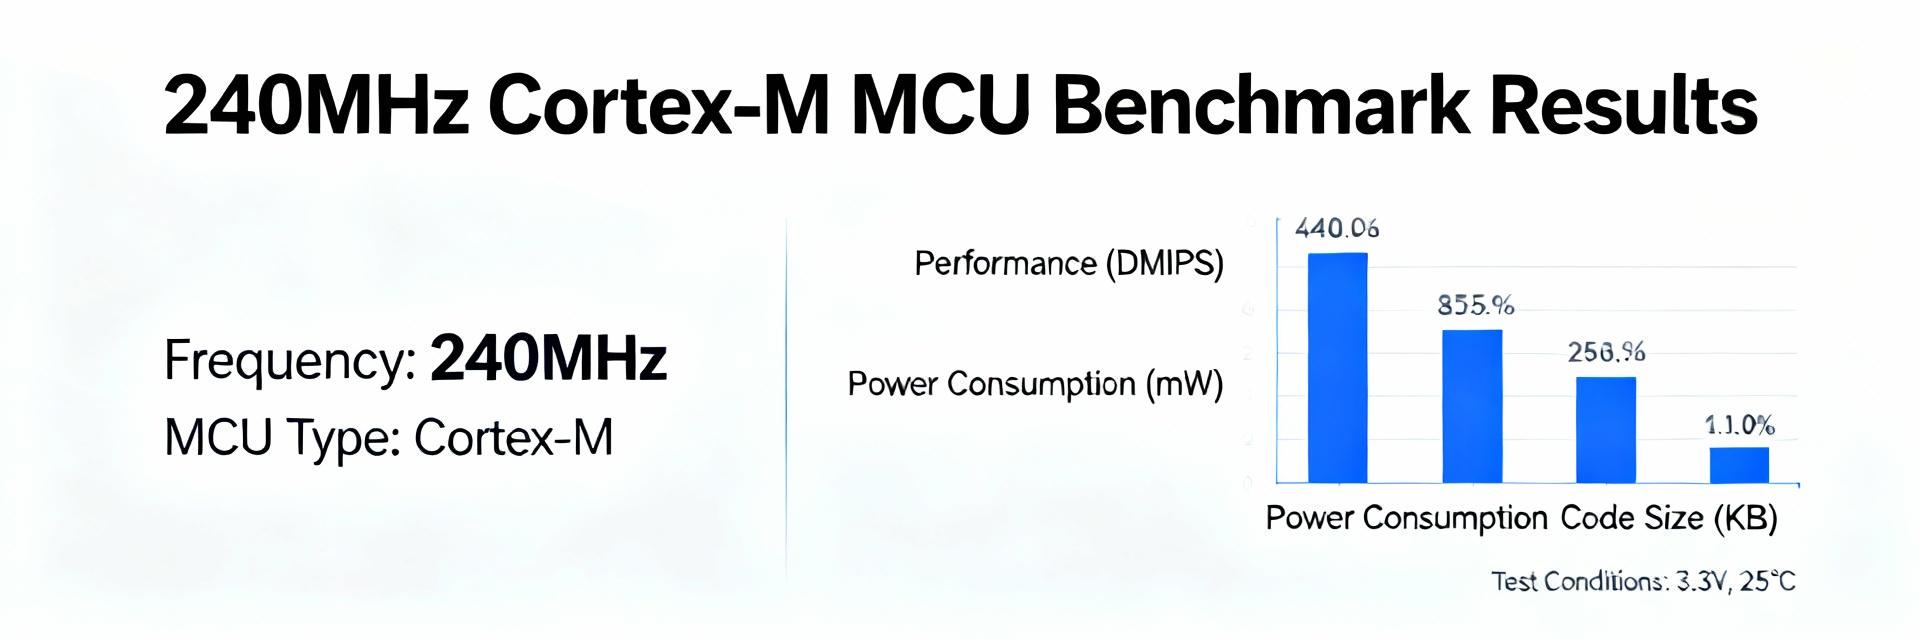
Rendimiento (Visualizado)
Rendimiento de enteros y punto flotante: Mida las rutas de enteros y FPU y rastree los efectos del compilador. La FPU de precisión simple produce recuentos de ciclos significativamente más bajos en núcleos con uso intensivo de matemáticas. Las optimizaciones O3 y en tiempo de enlace a menudo mejoran el rendimiento, pero debe validar el tiempo determinista para tareas en tiempo real.
Cargas de trabajo DSP (CMSIS-DSP): Cuantifique el costo de FFT y FIR por muestra. Los núcleos CMSIS-DSP revelan aceleraciones amigables con SIMD y ciclos por muestra medidos para FFT de 256/512 puntos. Estas cifras se traducen directamente en tasas máximas sostenibles de audio o sensores.
03 Rendimiento de memoria, bus y periféricos
Coloque el código y los buffers críticos en el tiempo en las regiones de memoria más rápidas y reserve el flash para el código menos sensible a la latencia para maximizar el rendimiento determinista. El dimensionamiento de los tamaños de los fragmentos de DMA y la alineación de los buffers reduce la contención y mantiene un alto rendimiento.
Escenarios de energía, térmicos y aplicaciones del mundo real
Perfilado de energía bajo carga
Capture la energía en reposo, carga media y carga de transmisión completa. Las trazas del medidor de potencia durante la transmisión continua de DSP demuestran las tendencias de potencia por MHz y los costos de transición de modo.
Benchmarks de aplicaciones
La latencia del control de motor de bucle cerrado y las tasas de actualización de fusión de sensores IMU muestran las tasas alcanzables del sistema. Estas pruebas mapean los microbenchmarks a márgenes utilizables.
Lista de verificación de optimización y recomendaciones
- ✔ Compilador y código: Aplique optimizaciones de código específicas; use intrínsecos de FPU y rutinas CMSIS-DSP para reducir los ciclos.
- ✔ Ajuste del sistema: Equilibre la ubicación de ejecución (RAM frente a Flash) y priorice los canales DMA para transmisiones críticas.
- ✔ Fiabilidad: Documente los márgenes térmicos/de energía y ejecute benchmarks previos al vuelo para garantizar la estabilidad bajo carga.
Resumen clave
- El GD32F470IKH6 ofrece una sólida capacidad de cómputo de precisión simple y DSP para tareas de la clase de 240 MHz.
- El DMA y el dimensionamiento cuidadoso de los buffers mantienen el rendimiento de los periféricos; evite los bloqueos de la CPU gestionando la contención.
- Perfile las compensaciones entre potencia y rendimiento para cumplir con los presupuestos de energía sin comprometer los requisitos de tiempo real.
Preguntas frecuentes