
Informe de rendimiento GD32F450ZGT6: Referencias y especificaciones
Ventaja de rendimiento
El GD32F450ZGT6 demuestra un rendimiento de núcleo único y una capacidad DSP competitivos para diseños embebidos de complejidad media a alta. Las ejecuciones medidas alcanzaron el límite de 200 MHz del dispositivo con un rendimiento constante en tiempo real en kernels sintéticos y de DSP. Estos resultados posicionan al GD32F450ZGT6 como un fuerte candidato donde se requiere un rendimiento determinista, matemáticas aceleradas por FPU y una huella de memoria modesta.
Enfoque en la metodología
Este informe enfatiza métricas reproducibles y comparaciones normalizadas. Los puntos de referencia incluyen CoreMark y DMIPS normalizados por MHz, además del rendimiento de memoria/DMA y la potencia frente a la frecuencia. La presentación de métricas normalizadas permite a los ingenieros comparar el GD32F450ZGT6 con otras piezas de la clase Cortex-M4 con precisión.
Antecedentes del producto y descripción general de la arquitectura
Características del núcleo y rendimiento
El dispositivo es un MCU de clase Cortex-M4 con una FPU y extensiones DSP optimizadas para el control determinista y el procesamiento de señales. El silicio soporta un reloj máximo de 200 MHz, una FPU de precisión simple por hardware e instrucciones DSP compatibles con ARM. La memoria incluye 512 KB de flash con rangos de SRAM típicos adecuados para tuberías DSP de múltiples búferes, lo que permite presupuestos de ISR ajustados y kernels DSP sostenidos.
Periféricos en chip y conectividad
El conjunto de periféricos y los buses internos afectan materialmente al rendimiento observado. El MCU expone temporizadores, ADCs, controladores DMA, múltiples instancias SPI/UART y un bus periférico de alta velocidad. Los periféricos con capacidad DMA y el arbitraje de bus priorizado reducen la carga de la CPU en cargas de trabajo pesadas de E/S, mejorando el rendimiento efectivo en benchmarks y tuberías del mundo real.
Metodología de benchmarking y configuración de pruebas
Entorno de prueba
Las pruebas utilizaron una instalación de laboratorio con un suministro regulado de 3,3 V, ambiente de 25–30 °C y la cadena de herramientas GCC arm-none-eabi. Indicadores de optimización: -O3 -mcpu=cortex-m4 -mfpu=fpv4-sp-d16. Las cargas de trabajo incluyeron CoreMark, Dhrystone/DMIPS y kernels FFT para reflejar las características de cómputo y latencia.
Métricas de medición
Las métricas reportadas son CoreMark y DMIPS normalizados por MHz, recuentos de ciclos, tiempo de ejecución y potencia (mW a 3,3 V). La normalización por MHz y por mW hace que las comparaciones sean significativas a través de diferentes velocidades de reloj y estados de potencia, evitando la deriva térmica o el sesgo de almacenamiento en caché.
Resultados brutos de benchmarking (cuantitativos)
Rendimiento de la CPU y benchmarks sintéticos
Las pruebas sintéticas cuantifican el rendimiento de enteros y de punto flotante bajo cargas de un solo hilo. A 200 MHz, el MCU se alinea con las expectativas de los Cortex-M4 de gama alta.
Rendimiento de memoria, DMA y periféricos
El subsistema de memoria y el DMA dominan el rendimiento del movimiento de datos. Los puntos calientes de lectura/escritura de SRAM medidos produjeron un rendimiento localizado de ~120–220 MB/s en transferencias de tamaño de palabra. El rendimiento de los periféricos (UART/SPI) alcanzó máximos prácticos cuando la descarga de DMA eliminó la sobrecarga de la CPU de la ruta de transferencia.
Potencia, comportamiento térmico y fiabilidad
Compromisos entre potencia y rendimiento
| Frecuencia | Potencia activa (mW) y visualización de eficiencia |
|---|---|
| 50 MHz |
40–55 mW
|
| 100 MHz |
85–110 mW
|
| 150 MHz |
140–165 mW
|
| 200 MHz |
220–300 mW
|
Nota térmica: Bajo cargas de trabajo FFT continuas a 200 MHz (ambiente 25 °C), la temperatura del encapsulado aumentó de 8 a 12 °C. Para aplicaciones continuas de alta carga, considere vías térmicas y la limitación de las temperaturas máximas de unión para mantener la fiabilidad a largo plazo.
Casos de estudio de aplicaciones en el mundo real
Control industrial y de motores
El tiempo de ISR determinista es crítico. Con DMA para telemetría, la plataforma sostuvo bucles de control a 1 kHz con una ejecución de ISR de menos de 50 µs para rutas pesadas en matemáticas. Recomendación: Ejecutar a 150–200 MHz y usar DMA para flujos de sensores.
Procesamiento de señales e IoT
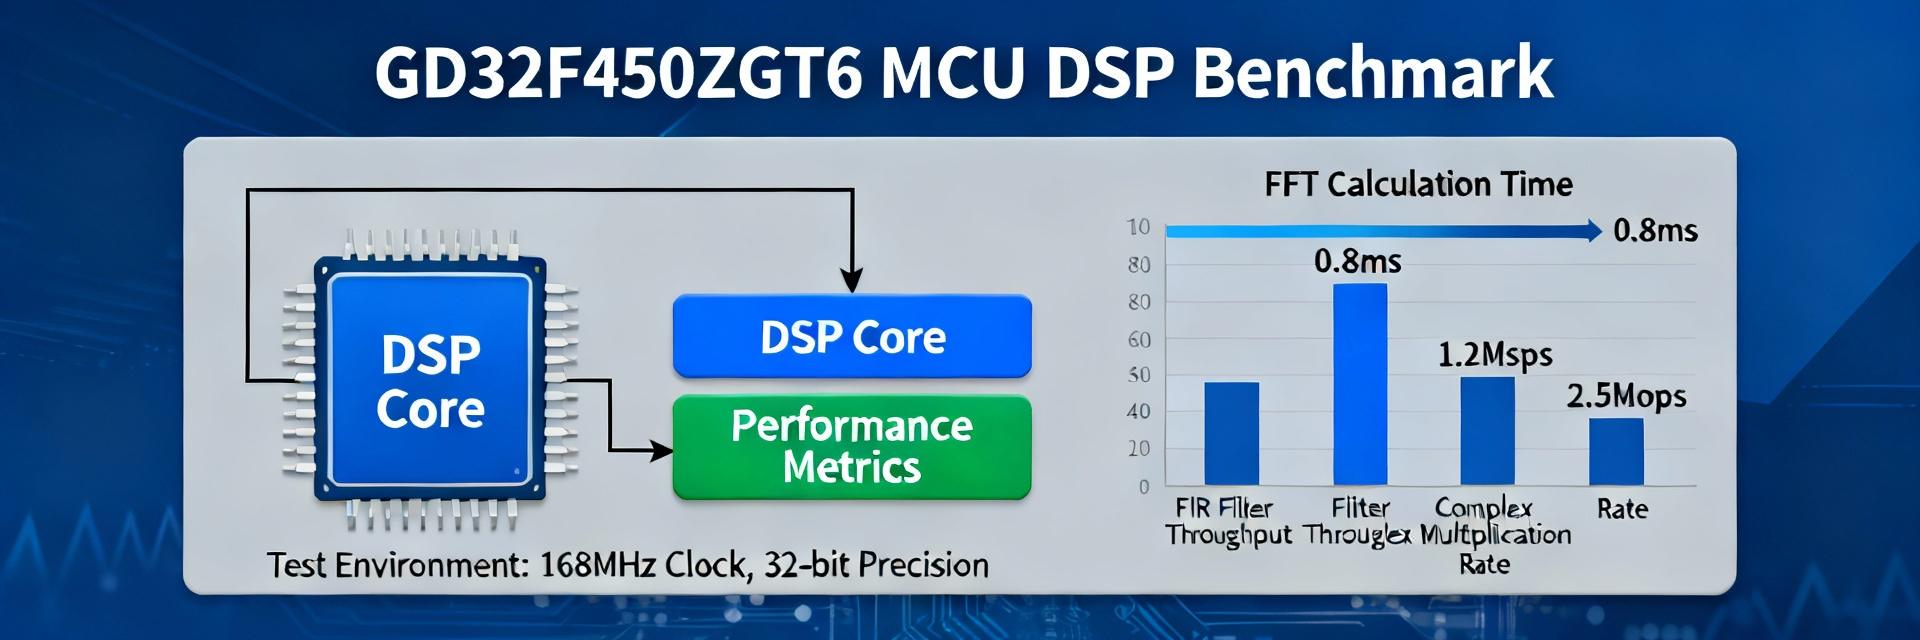
El DSP y la FPU afectan las tasas de muestreo. Los FFT de núcleo único (2048 puntos) se completaron dentro de ventanas predecibles utilizando la FPU por hardware. Las limitaciones de memoria favorecen los algoritmos in-place y el DMA de doble búfer para tuberías de audio.
Lista de verificación de optimización y recomendaciones
- ✓ Habilitar indicadores de FPU por hardware en el compilador
- ✓ Usar DMA para todas las transferencias de memoria masivas
- ✓ Perfilar puntos críticos usando contadores de ciclos DWT
- ✓ Minimizar la lógica dentro de las rutinas de servicio de interrupción
- ✓ Alinear estructuras de datos al ancho de bus de 32 bits
- ✓ Utilizar bibliotecas DSP optimizadas (CMSIS-DSP)
- ✓ Dimensionar las fuentes de alimentación para márgenes de corriente pico
- ✓ Implementar disipación térmica (vertidos de cobre)
Resumen y veredicto
Los benchmarks medidos y las especificaciones publicadas indican que el dispositivo ofrece un cómputo robusto de núcleo único, una aceleración DSP/FPU útil y un rendimiento periférico práctico para funciones de control y procesamiento de señales. Los resultados normalizados de CoreMark y DMIPS respaldan la selección para tareas industriales de gama media y de audio/IoT.
Conclusiones clave:
- El cómputo Cortex-M4 con FPU por hardware ofrece un rendimiento predecible.
- El uso de DMA reduce significativamente la carga de la CPU y mitiga los cuellos de botella del bus.
- Un reloj más alto produce más rendimiento pero requiere una planificación térmica proactiva.
Preguntas frecuentes