
Rendimiento del MCU Cortex-M4: puntos de referencia y perspectivas de poder
Encuestas de referencia recientes y mediciones de laboratorio muestran que los MCU Cortex‑M4 pueden diferir en varias veces en el rendimiento del mundo real y en órdenes de magnitud en la corriente de reposo (standby) según el reloj, la configuración de la memoria y los modos de energía.
Este artículo sintetiza métodos de medición, rangos de rendimiento observados, perspectivas de energía y orientación práctica de ajuste para que los diseñadores puedan evaluar las piezas de manera consistente y optimizar el rendimiento por vatio. El propósito es proporcionar un enfoque reproducible: qué pruebas sintéticas y de aplicación ejecutar, qué condiciones informar, los rangos esperados a nivel de sistema y de un solo núcleo, y un plan de prueba compacto que los diseñadores pueden reutilizar durante la selección y validación. Los términos "benchmarks" y "perspectivas de energía" se utilizan en todo momento para resaltar las consideraciones de medición y energía.
Antecedentes: lo que la arquitectura de MCU Cortex‑M4 significa para el rendimiento
Características del núcleo que dan forma a los benchmarks
Punto: El pipeline, la FPU opcional, las instrucciones DSP, el comportamiento del NVIC y las opciones de dominio de reloj establecen la capacidad de cómputo bruta.
Evidencia: Las comparaciones de laboratorio muestran que el código de enteros sigue ciclos por instrucción constantes, mientras que el código de coma flotante se beneficia drásticamente cuando hay una FPU presente.
Explicación: Para tareas de cómputo, la presencia de una FPU e instrucciones DSP reduce el recuento de instrucciones y la latencia; el modelo de interrupción y la profundidad del pipeline afectan el jitter y la latencia en el peor de los casos en cargas de trabajo reales.
Factores de memoria y periféricos que alteran el rendimiento efectivo
Punto: Los estados de espera de la memoria flash, los anchos de bus, las cachés/TCM y el DMA determinan el rendimiento efectivo más allá de los MIPS del núcleo.
Evidencia: Los bucles de aplicación medidos a menudo se detienen por recuperaciones de flash o contención de bus, convirtiendo un CoreMark/MHz alto en un rendimiento de sistema más bajo.
Explicación: Reducir los estados de espera de flash, colocar el código crítico en TCM y usar DMA para el movimiento de datos puede recuperar grandes fracciones del rendimiento perdido en escenarios limitados por la memoria.
Metodología de Benchmark: Cómo medir correctamente el rendimiento del Cortex‑M4
Pruebas sintéticas y del mundo real recomendadas
Punto: Utilice una combinación de micro-benchmarks y aplicaciones representativas para revelar fortalezas y debilidades.
Evidencia: Las suites sintéticas (CoreMark, DMIPS, núcleos DSP) aíslan el rendimiento del núcleo, mientras que las pruebas de aplicación (filtro FIR, bucle de control de motor, AES) muestran los cuellos de botella del sistema.
Explicación: Combine ambos tipos: pruebas sintéticas para normalización y pruebas de aplicación para capturar interacciones de memoria, DMA y periféricos relevantes para su producto.
Configuración de prueba, repetibilidad y prácticas de informes
Punto: Controlar las condiciones de prueba es esencial para comparaciones reproducibles.
Evidencia: Las variaciones en las banderas del compilador, la habilitación de FPU, el reloj y los estados de espera de flash cambian las puntuaciones en decenas de puntos porcentuales en un código idéntico.
Explicación: Informe los parámetros obligatorios (MHz del reloj, estados de espera de flash, mapa de memoria, FPU activada/desactivada, banderas del compilador, incertidumbre de medición) y use medidores de potencia calibrados u osciloscopios para la medición de corriente.
Benchmarks de rendimiento: análisis de datos y rangos típicos
Visualización de la eficiencia de cómputo (relativa)
Cómputo de un solo núcleo: patrones de enteros frente a coma flotante
Punto: Las cargas de trabajo de enteros y flotantes muestran una eficiencia por MHz distinta.
Evidencia: Los datos agregados indican que CoreMark/DMIPS por MHz para cargas de trabajo de enteros es relativamente estable, mientras que las cargas de trabajo flotantes pueden experimentar grandes aceleraciones cuando hay una FPU presente.
Explicación: Espere aceleraciones porcentuales significativas en el código DSP con un uso intensivo de matemáticas con instrucciones FPU/DSP; para el código de enteros, concéntrese en la programación de instrucciones y la ubicación en la memoria para mejorar los ciclos por operación.
Rendimiento del sistema: casos limitados por memoria y periféricos
Punto: El rendimiento del sistema puede divergir fuertemente de las métricas exclusivas del núcleo cuando ocurren paradas de memoria o contención de periféricos.
Evidencia: El rendimiento de la aplicación medido a menudo cae cuando no se usa DMA o cuando el rendimiento de lectura de flash limita la recuperación de instrucciones.
Explicación: Visualice el rendimiento trazando operaciones/segundo en diferentes configuraciones de memoria; identifique si el DMA, la caché/TCM o el arbitraje de bus cambian el cuello de botella.
Perspectivas de Energía: Medición e Interpretación del Uso de Energía
Potencia activa frente a mezcla de carga de trabajo
Punto: La corriente activa escala con la frecuencia y la mezcla de instrucciones, y el uso de la FPU cambia el equilibrio entre potencia y rendimiento. Evidencia: Los gráficos de corriente activa frente a reloj suelen mostrar una escala casi lineal para las cargas de trabajo de enteros y pendientes diferentes cuando el uso intensivo de la FPU reduce el recuento de instrucciones pero aumenta la actividad instantánea del núcleo. Explicación: Informe Iactive (mA/µA) frente a la frecuencia para cargas de trabajo representativas de enteros y flotantes para mostrar los compromisos y si la FPU produce una mejor energía por operación.
Modos de bajo consumo, latencia de activación y energía por tarea
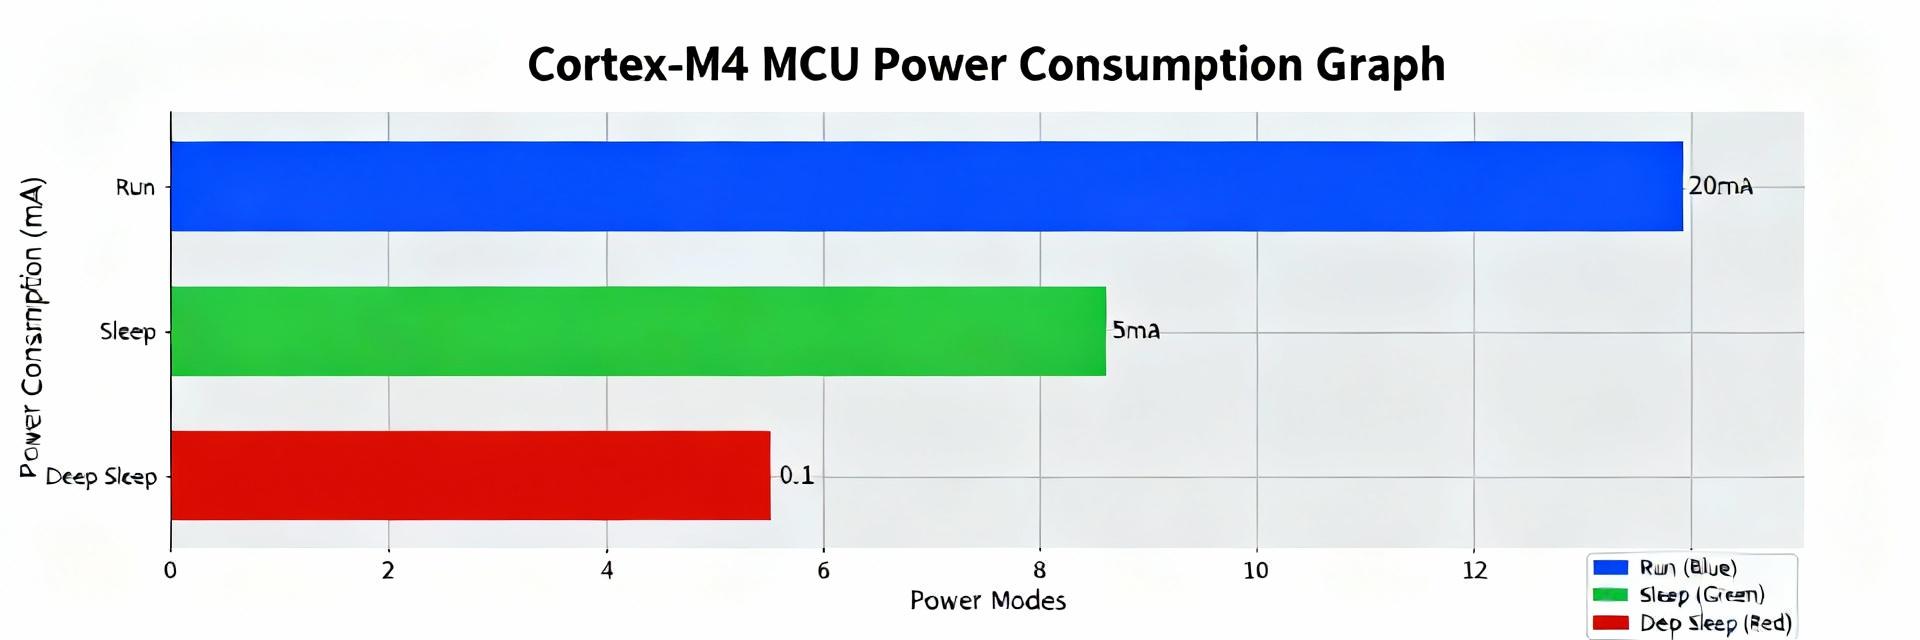
Punto: Las corrientes de reposo y la latencia de activación determinan la potencia promedio en sistemas con ciclo de trabajo. Evidencia: Las corrientes de sueño profundo pueden ser órdenes de magnitud menores que las activas, pero los tiempos de activación prolongados inflan la energía por evento. Explicación: Mida Isleep, el tiempo de activación y la energía de cómputo por transacción (µJ/op) combinando la energía de activación y el procesamiento activo; use esa métrica para elegir la estrategia de reposo para las tasas de eventos objetivo.
Optimización y compromisos: cómo mejorar el rendimiento por vatio
| Nivel de estrategia | Elementos accionables | Descripción del impacto |
|---|---|---|
| Nivel de software | Banderas del compilador (O2/O3), intrínsecos de DSP, descarga de DMA. | Reduce el recuento de instrucciones y los ciclos de CPU; las mayores ganancias rápidas para la eficiencia. |
| Nivel de sistema | Sintonización del dominio de reloj, estados de espera de Flash, procesamiento por lotes de periféricos. | Reduce la potencia promedio sin cambios profundos en el código; mejora la energía de las tareas limitadas por E/S. |
| Estrategias de hardware | Escalado de voltaje (si es compatible), utilización de caché/TCM. | Minimiza la contención del bus y reduce el consumo de energía del núcleo. |
Lista de verificación de selección práctica y plan de prueba para diseñadores
Lista de verificación de selección rápida
Punto: Mapee las clases de productos a las métricas objetivo para reducir las opciones rápidamente.
Evidencia: Los sensores de batería necesitan una corriente de reposo baja, mientras que los controladores de motor requieren una latencia determinista.
Explicación: Utilice umbrales como el CoreMark objetivo y los requisitos de FPU. Como ejemplo, valide cualquier dispositivo candidato (por ejemplo, GD32F303CET6) frente a estos umbrales durante la evaluación.
Ejemplo de plan de prueba
Punto: Un plan de prueba conciso y repetible garantiza comparaciones equitativas.
Evidencia: Una plantilla simple con objetivos, condiciones y criterios de aprobado/reprobado acelera las decisiones.
Explicación: Incluya las cifras requeridas (CoreMark frente a MHz, energía por operación). Enumere un ejemplo de dispositivo bajo prueba (DUT) como el GD32F303CET6 como marcador de posición para la validación del equipo.
Resumen
Una metodología cuidadosa revela por qué el rendimiento y la energía de los MCU Cortex‑M4 varían ampliamente: las características del núcleo, el subsistema de memoria, la arquitectura periférica y los modos de energía interactúan para crear grandes diferencias en los sistemas reales. Al estandarizar las pruebas, informar los parámetros requeridos y aplicar optimizaciones priorizadas, los equipos pueden seleccionar y ajustar piezas para cumplir con los objetivos de rendimiento y batería de manera eficiente.
- ● Estandarice los benchmarks e informe el reloj, los estados de espera de flash, las banderas del compilador y el estado de la FPU para permitir comparaciones justas de MCU Cortex‑M4.
- ● Distinga los casos limitados por cómputo de los limitados por memoria; use TCM/cachés y DMA para recuperar el rendimiento del sistema.
- ● Mida la energía por operación, incluido el costo de activación para sistemas con ciclo de trabajo; optimice primero el software, luego los relojes del sistema y la configuración de la memoria.
Preguntas frecuentes
¿Cómo debo realizar un benchmark de un MCU Cortex‑M4 para cargas de trabajo DSP?
¿Qué métricas de potencia son esenciales al comparar opciones de MCU Cortex‑M4?
¿Habilitar la FPU siempre puede mejorar la eficiencia energética en un MCU Cortex‑M4?